

実運用
話題のJevを入れてみたら、ほとんどの場所で要らなかった──判断をコード・Jev・LLMに仕分ける
9月15日にTypeSafe AIが「Jev」というAIを発表して、僕のタイムラインはその話で埋まった。速い、安い、DOOMをプレイするデモまである。こういうものを見ると触らずにいられない性格なので、発表から1週間後には、うちのAI秘書のRyokoに組み込んで公開していた。
先に結果を書く。Ryokoの定期ジョブを15本作り変えて、Jevを使ったジョブは0本だった。Jevが入ったのは別の1箇所、Slackの空気読みだけだ。新しいAIを試して最初に突きつけられたのは、「その判断、そもそもAIが要るのか」という問いだった。
Jevは文章を書かない。選ぶだけのAIだ
ChatGPTやClaudeは質問に文章で答える。Jevは書かない。用意された選択肢から「これ」と選ぶだけだ。学校のテストでいえば、ChatGPTやClaudeが記述式で、Jevはマークシートにあたる。このたとえはQiitaの@yushibatsさんの記事から借りた。
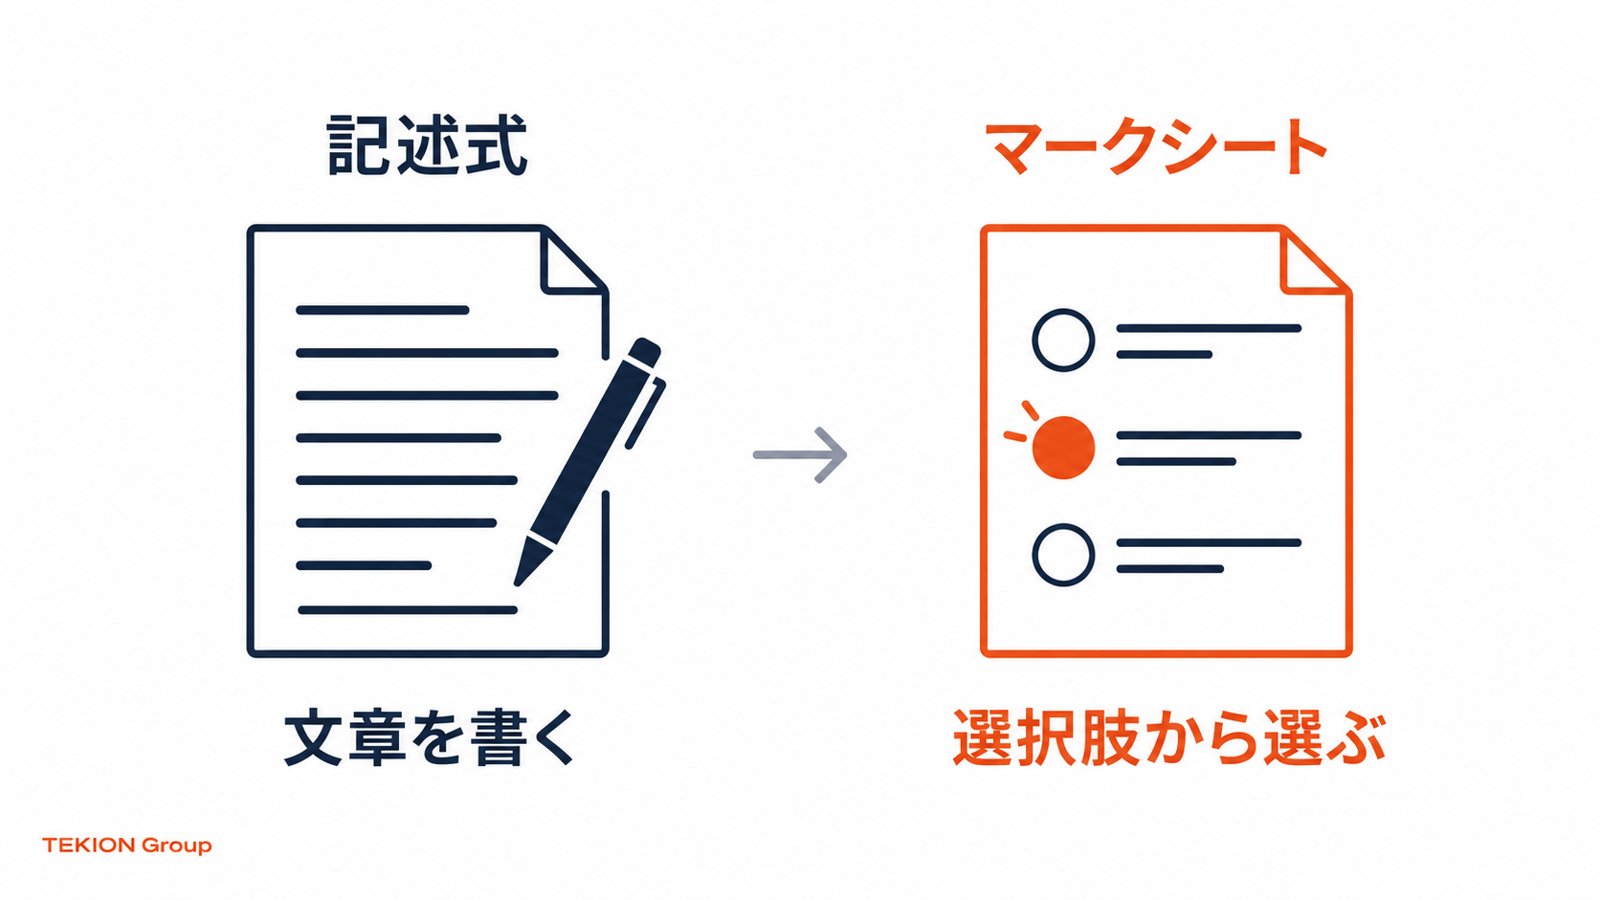
選択肢を用意するのは人間の側で、Jevは「どの欄が、どのくらい確からしいか」を返す。聞き方は3つしかない。選ぶ(Choice)、採点する(Score)、はい・いいえの確からしさを返す(Noul)。文章を一文字ずつ組み立てないので、返事は一瞬で、料金も安い。
苦手もはっきりしている。計算、日付の比較、何段も重ねる推論は向かない。日本語は英語ほど得意ではないと、TypeSafe AI自身がドキュメントに書いている。自社の文章で試してから使うのが安全だ。
判断を任せる相手が1つ増えた、と考える
Jevを「ChatGPTの安い版」と捉えると、使いどころを間違える。判断を任せる相手が1つ増えた、と考えたほうがいい。
- 条件がはっきり決まる判断は、コード(プログラム)に任せる
- 意味を読まないと決まらないが、答えは選ぶだけで足りる判断は、Jevに任せる
- 書く、深く考える、調べる仕事は、LLM(ChatGPTやClaude)に任せる
仕分けるときの問いは2つで足りる。ルールで書けるか。答えは選択肢で足りるか。 メールでいえば、「新着があるか」はコード、「このメールは急ぎか」はJev、「返信を書く」はLLMになる。
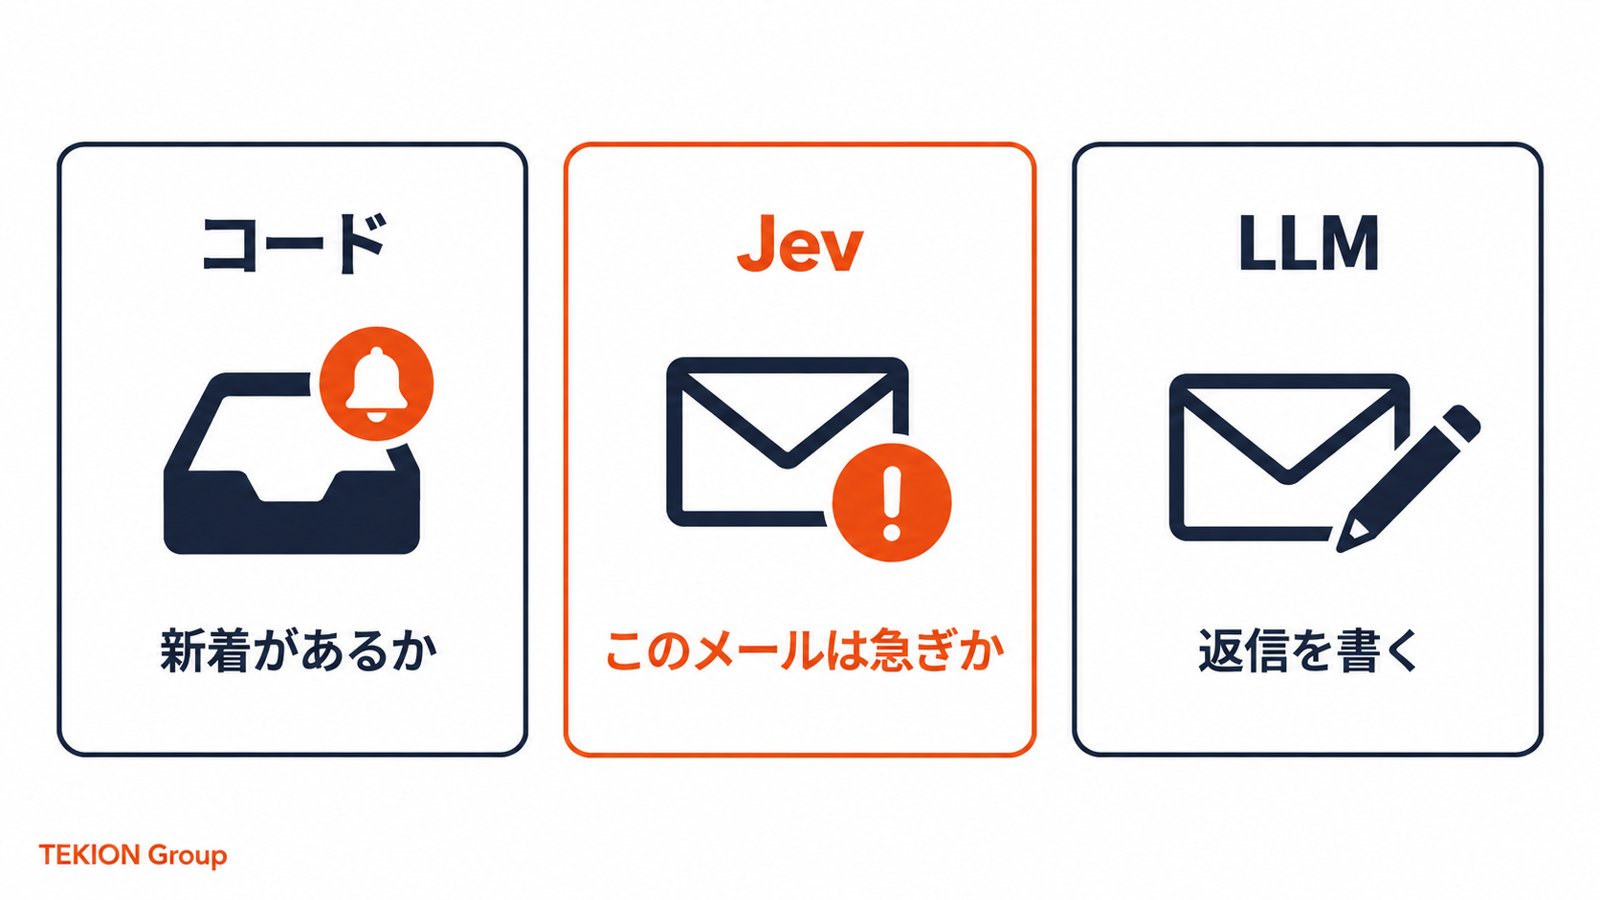
当たり前に見える。僕もそう思っていた。自分のところを調べるまでは。
巡回の半分は、AIを起こして「何もありませんでした」で終わっていた
Ryokoは毎日いくつもの定期ジョブを回している。未返信のメッセージはないか、新しい議事録は届いていないか、といった巡回だ。Jevの入れどころを探すために実行履歴を洗うと、巡回のたびにAIを起動していて、その半分ほどは「処理するものがありませんでした」で終わっていた。AIを起こして、AIが「何もないですね」と確認して、寝る。これを毎日何十回もやらせていたことになる。設計したのは僕だ。
「処理するものがあるか」は、件数を数えれば決まる。意味を読む必要すらない。Jevの出番ですらなく、コードの仕事だった。
そこで、スクリプトを直接実行して、処理するものがあるときだけAIを起こす形に作り変えた。作り変えたジョブは15本。7本はコードだけで完結し、残りの8本も必要なときだけAIを起こす形になった。Jevを使ったジョブは0本だ。
「とりあえずAIに全部考えさせる」で組んだ仕組みは、うちだけのものではないと僕は見ている。エージェントを早く入れた会社ほど、同じ空振りを抱えている可能性が高い。
Jevがはまったのは、Slackの空気読みだった
Jevが入ったのはSlackだ。AIをSlackに入れて最初に困るのは、頭の良さより間の悪さである。雑談に割り込む。誰に向けたのか分からない発言にも、毎回律儀に返事をする。会議室に、誰かが何か言うたびに「それ、私がやりましょうか」と口を挟む新人がいる状態だ。悪気はないが、周りは疲れる。
だからRyokoには、発言のたびに「返事をする・絵文字だけ返す・黙っている」を先に決める受付係を置いていた。空気読みトリアージと呼んでいる。困っていたのは、この一呼吸の長さだ。以前は発言のたびに小型のAIを別に起動して相談していたので、「ありがとう」に絵文字を1つ返すだけでも数秒かかった。相談相手をJevに替えると、これが一瞬になった。
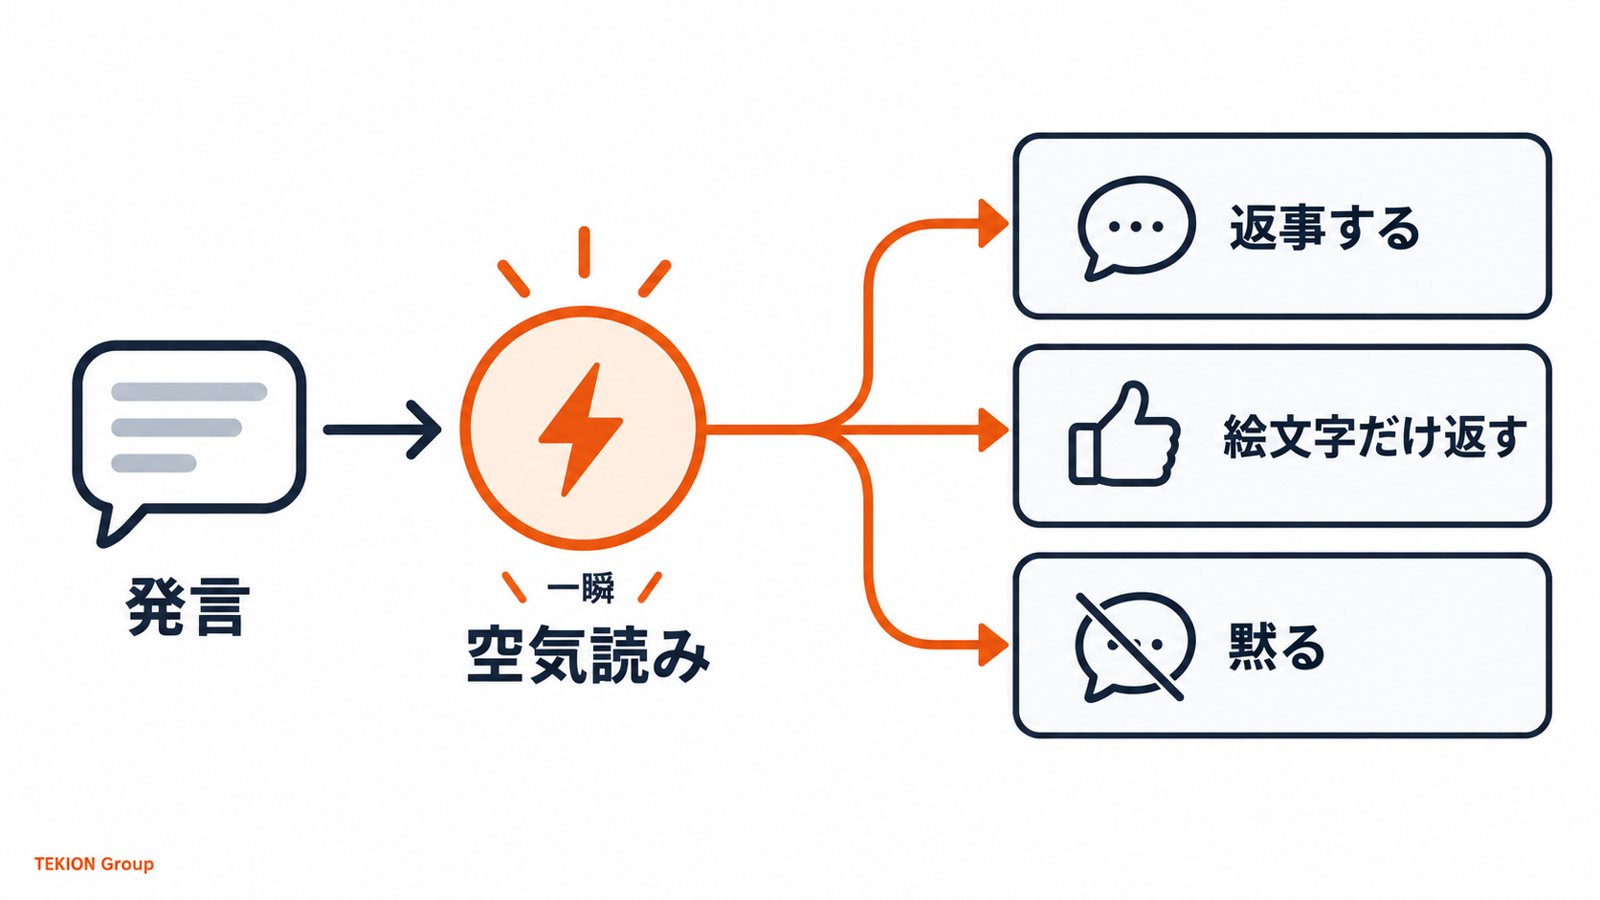
ここだけはまった理由は、さっきの2つの問いで説明がつく。返事が要るかどうかは意味を読まないと決まらず、うちの使い方では単純な条件分岐で書き切れなかった。一方で答えは三択なので、文章を書くAIを起こすほどでもない。しかも発言のたびに走るから、判定の速さがそのまま使い心地に出る。コードでは決め切れず、LLMでは大げさ。Jevの居場所は、この隙間にある。
AIには小さく聞いて、決めるルールはコードに持たせる
作ってみていちばんの収穫は、速さより設計のほうだった。
Jevには「返事すべきか」とまとめて聞かない。誰に向けた発言か、何を求めているか、自分の返事が求められているか、と小さな問いに分けて聞く。返ってきた答えを、コードのルールで三択にまとめる。黙ると決めるときほど高い確からしさを求め、答えどうしが食い違っていれば採用しない。メンションやDMは、Jevに聞く前にコードでさばく。返事の文章を書くのはClaude CodeやCodexだ。
AIには小さな問いだけを任せて、決めるルールは人間が書いたコードに持たせる。こうしておくと「なぜ黙ったのか」を後から追える。Jevの答えをどう組み合わせ、どのルールで黙ると決めたかが、コードの上に残るからだ。丸ごとAIに決めさせていた頃は、これができなかった。
自分の仕組みで試す。判断を書き出して、2つの問いを当てる
Jevを触る前にできることがある。紙でも表計算でもいいので、次の順にやってみてほしい。
- 自社のAIや自動化の仕組みの中にある「判断」を、1行ずつ書き出す。「新着があるか」「急ぎか」「誰に回すか」「どう返信するか」くらいの粒度でいい
- それぞれに「ルールで書けるか」と問う。書けるならコードに任せ、そこからAIを外す
- 残りに「答えは選択肢で足りるか」と問う。足りるならJevのような判断専用AIの候補になり、足りないならLLMの仕事として残す
僕の場合、この仕分けで定期ジョブ15本からJevの出番は出てこなかった。代わりに、AIを起こさなくてよい場所が見つかった。新しいAIを足す前に、その判断がコードで済まないかを確かめる。順番はこれで合っていると思う。
OpenRyokoを使っている方は、設定のSlackの項目から、空気読みの判定をJevに切り替えられる。リリースノートは https://github.com/rsensui2/OpenRyoko/releases に、Jevそのものの公式ドキュメントは https://docs.typesafe.ai/introduction にある。マークシートのたとえは、Qiitaの記事 https://qiita.com/yushibats/items/472325ce548da370ed5d による。
この話は、Ryokoと受付係のやりとりとして描いた学習漫画にもした。会話で追いたい方はこちらへ → https://ai-agent.co.jp/manga/what-is-jev/
Ryokoが5分半で話す動画版もある。移動中に聞きたい方はこちらへ → https://youtu.be/Ff5ipRvFBGs

この記事を書いた人
泉水亮介 / Ryosuke Sensui
TEKION Group CEO / 武蔵野大学アントレプレナーシップ学部 客員研究員
非エンジニアとして2022年からAI駆動開発を実践し、100を超えるアプリ・AIエージェントを開発。国内唯一の大学単位認定Vibe Coding講義(武蔵野大学)を担当し、TEKION Groupでは自作のAIエージェント基盤で自社業務の9割以上を回している。
詳しいプロフィールを見る →出典/元原稿: ~/auto-agent/drafts/2026-09-22-what-is-jev.md
関連記事
毎朝の動画ニュースを1本1円で作る──AIに作らせない範囲を決めるという設計
毎朝のAIニュースに動画を付けた。外部APIに払っているのは音声合成だけで1本約1円。生成AIに何を作らせないかを決めるだけで、費用も品質のばらつきも同時に落ちる。
AIの報告を止める前に、外部監視を配線する──朝の6本を1通に束ねた報告規約
AIの定期報告が読みきれなくなった。no-op報告を全廃し朝の6本を親1通+スレッドに束ねた実録。通知を減らして観測性を上げる順序と、最小レシピ。
新機能の発表は「買うか」ではなく「差分表」で受ける — 自前のエージェント基盤でなぞったら、欠けは2つだけだった
話題のAIワークスペースの新機能を、自前のエージェント基盤と1行ずつ突き合わせた実録。欠けていた2つをその日に最小実装するまでと、自分の環境で試せる差分表の作り方。